
招揽具身人才、扩充真实世界数据、研发能控制机器人的模型——过去几个月,OpenAI、Anthropic、Google正把越来越多的资源投向物理世界。
一个足以让整个具身行业重新思考的问题随之浮现:通用大模型,会成为机器人的默认大脑吗?专门做具身模型的团队,又还能在哪些能力上继续领先?
过去半年,这是行业被讨论最多、却没有数据回答的问题。10月20日,这个问题有了第一组正面交火的实测成绩:在具身评测平台RoboColiseum,来自OpenAI、Anthropic、Google的四款旗舰模型首次同台竞技——GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argon,在指令跟随、空间理解、通用操作、扰动适应四个维度上,接受完全相同的考题与同一把评分尺。
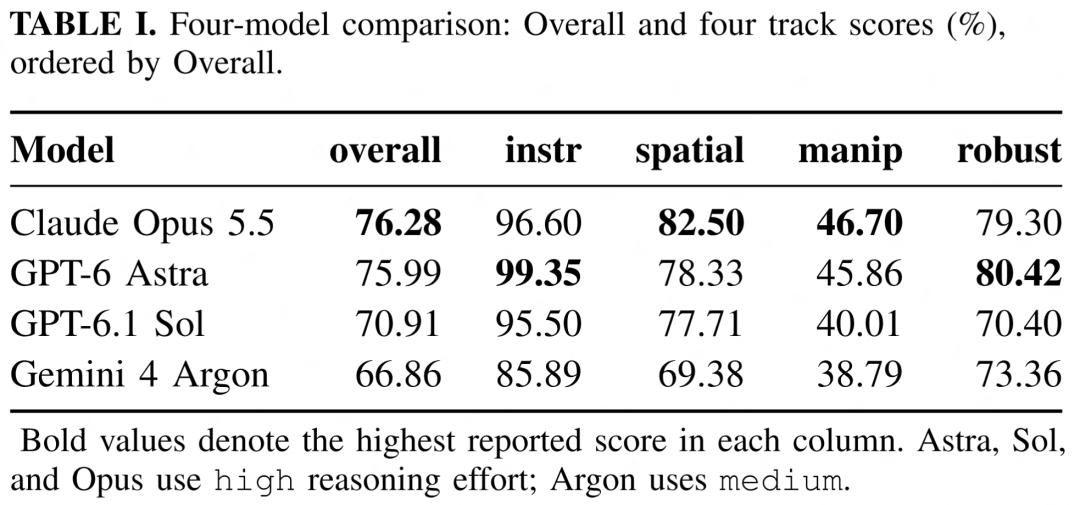
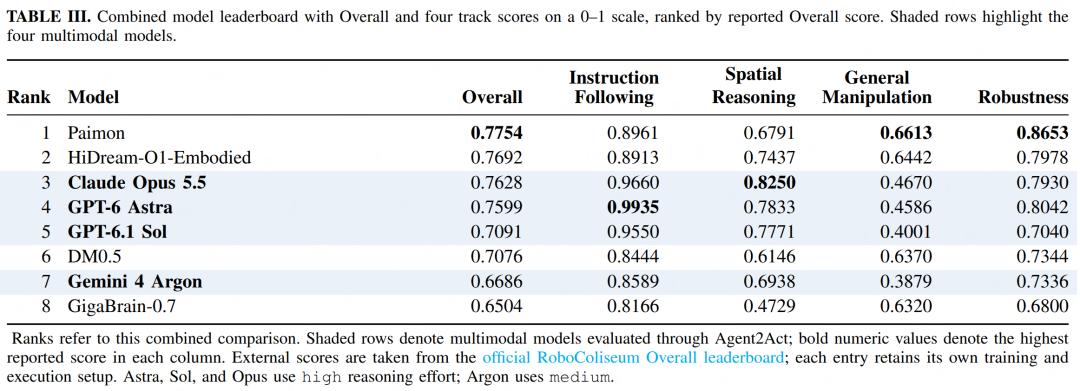
首轮成绩单:Claude Opus 5.5以76.28分的综合得分位列四款旗舰模型第一,GPT-6 Astra以75.99分紧随其后——而所有模型同台排总榜,前两名却是策略模型Paimon与HiDream - O1 - Embodied。
此外,Opus 5.5全轮评测的token总消耗最少。在图像质量受扰动的测试中,Opus得分76.47,Astra为67.60,Argon为59.57,GPT-6.1 Sol则跌至18.36,Astra在指令跟随(99.35)与整体扰动适应上最强,Opus则在空间理解与通用操作上领先。
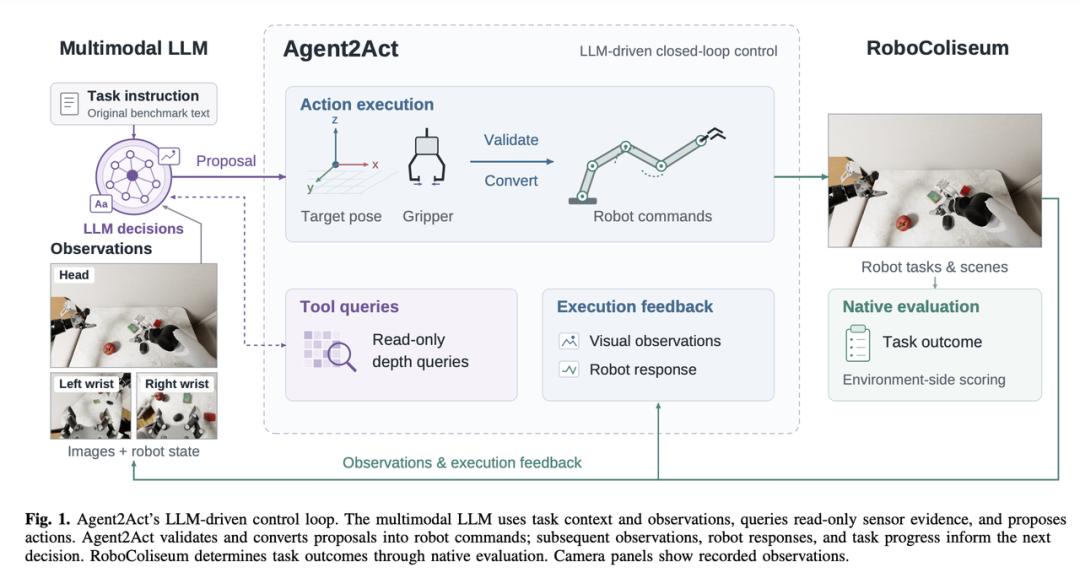
值得一提的是,四款模型共用完全相同的Agent2Act控制框架(harness)与原始任务指令(prompt)——比的不是谁的提示词工程更好,而是模型本身的具身原生能力。
01、同一套评测标准:大模型与策略模型正面交锋
踏入RoboColiseum具身角斗场,三巨头的旗舰大模型与策略模型,都要接受完全相同的评测标准和评分规则——四个维度,同一把尺子,以任务中的实际表现定胜负。
大语言模型之间,连控制框架和提示词也完全一致:共用相同的Agent2Act控制框架与原始任务指令,不增加任何任务专属提示。模型根据图像、机器人状态与执行反馈决定下一步动作;框架负责校验与执行,再将实际结果交回模型。动作有没有做到、任务有没有完成,最终由RoboColiseum的原生评测机制判定。
这场较量要回答的问题很直接:谁能听懂指令、看准位置、完成操作,并在环境变化后继续把任务做好?
02、Opus 5.5 综合第一还更省 Token
拿下最高综合分,同时用掉最少的 token——这是 Claude Opus 5.5 在这轮对决中交出的答卷。
在 RoboColiseum 具身角斗场,Opus 5.5 以 76.28 的综合评分,击败 GPT-6 Astra、GPT-6.1 Sol 和 Gemini 4 Argon,位列四款旗舰模型第一。
更值得关注的是:在技术报告统计的 Opus、Astra、Sol、Argon 四款模型中,Opus 全轮评测的 token 总消耗也是最少的。
Astra 也仍握有自己的优势:它在四款模型中的指令跟随和整体扰动适应评分最高;Opus 则在空间理解、通用操作上领先。
这场对决的看点因此更清楚了:Opus 拿下综合第一,也在与 GPT-6 双雄和Gemini 4的比较中做到了更少的 token 消耗。但各项能力的较量,仍有不同的赢家。
03、理解碾压,操作分野:总榜前二仍是策略模型
本轮评测最值钱的发现,是能力边界的首次量化:
理解层,旗舰大模型形成碾压。 零样本入场、零任务微调,四款大模型就拿下66.86 – 76.28的综合评分。指令跟随与空间理解两个维度上,大模型有明显优势。听懂指令、看懂空间——通用大模型确实已经很强。
操作层,策略模型仍大幅领先。 抓取、开门、倾倒、分拣——这些"做准做稳"的通用操作,四款大模型得分38.79 – 46.70,四款策略模型63.20 – 66.13。总榜上,Paimon ( 77.54)与 HiDream - O1 - Embodied ( 76.92 ) 力压 Opus 5.5 ( 76.28 ) 占据前两名。
一句话:旗舰大模型接管了"理解",但"操作"这张卷子,它们还没及格——而卷面最高分,写在策略模型的名下。
04、七组详细对比:拆解 Astra 控制机器人的关键环节
围绕GPT-6 Astra,研究团队做了七组"拆零件"实验,覆盖执行反馈、深度信息、历史记录、IK 检查、相机投影自检、夹爪几何和动作表示,三组结果值得全行业关注:
撤掉执行反馈,平均规划决策次数从16.7次暴涨到35.6次。深度与夹爪几何信息帮助模型找准位置、选对抓取姿态;执行反馈帮助它判断动作偏差。移除明确的执行偏差反馈后,平均规划决策次数从 16.7 次增至 35.6 次,模型不知道"刚才那一下做到没有",只能用试错硬扛。
删掉历史记忆,积木入盒成功率从100%跌到50%。在积木入盒任务中,完整系统全部成功;移除历史记录后,只完成了一半。失败的情况都已经抓起积木,却在放置阶段反复重复动作。
直接输出关节增量,10个任务完成8个。将末端位姿目标改为直接输出关节增量后,Astra 仍完成了 10 个任务中的 8 个,展示出对双臂与夹爪关节动作的规划能力,但需要更多执行步数。
这些实验进一步说明:看准目标、理解动作偏差、记住历史尝试,是把模型能力转化为有效机器人操作的重要环节。
05、全身协同,跨本体操作亮眼;灵巧手任务仍是明显短板
能协调底盘、躯干和双臂完成任务,也能换到不同机器人上操作——但面对一只碗、一根手机线,Astra 仍会遇到难题。
在 RoboColiseum 的补充探索中,我们进一步检验了 GPT-6 Astra 的全身控制、跨本体操作、灵巧手与精细操作能力,并将部分验证延伸到真实机器人。
全身控制:移动、抓取、投放,已经能连起来完成。
丢垃圾时,Astra 指挥机器人移动底盘、降低躯干,伸臂抓起目标,再转向、调整位置,把垃圾送进桶里。开门任务中,它完成开门后,还能继续控制底盘穿过去。
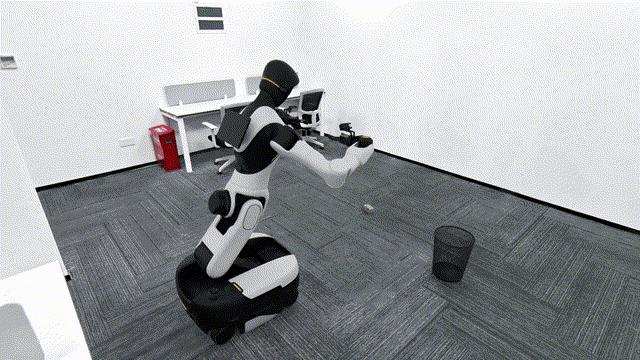
全身控制:Astra完成垃圾拾取与投放
全身控制:Astra移动取罐、携物行进与餐桌放置
跨本体操作:换一种“身体”,同一个模型还能继续干活。
同一个棋子收纳任务,通过统一接口与各本体的控制适配,Astra 在 ARX、AgileX、G1 和 G2 上都成功完成了拾取与放置。
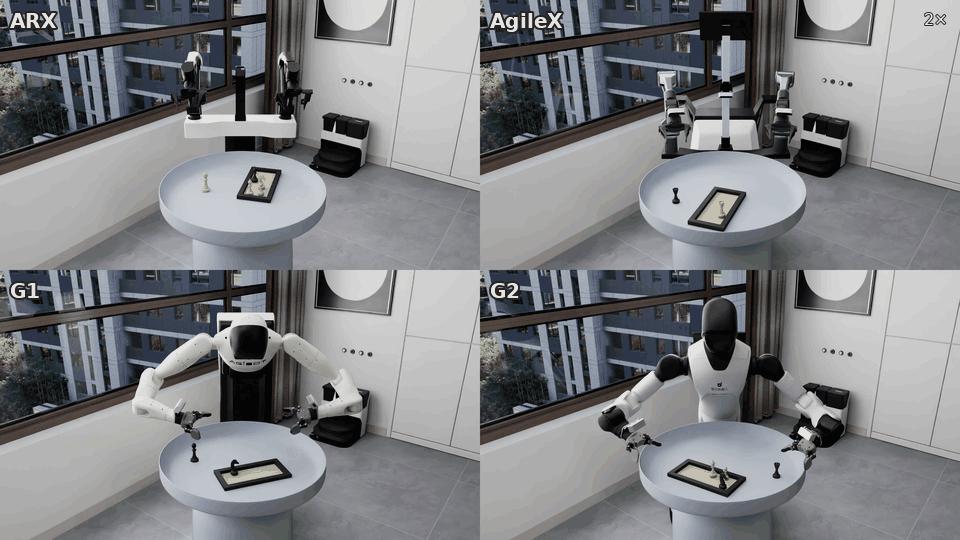
棋子收纳:Astra在4种本体上均可完成
灵巧手:能给每只手的 20 个手指关节下指令,却没能稳稳抓起一只碗。
在灵巧手叠碗实验中,Astra 能根据视觉与机器人状态调整手指和手腕。但这些调整始终没有形成稳定抓取,叠碗任务也未完成。即使进一步补充手指、手掌的几何信息,仍未成功。关节能够运动,距离多根手指协调接触、稳稳托住物体,还有明显差距。
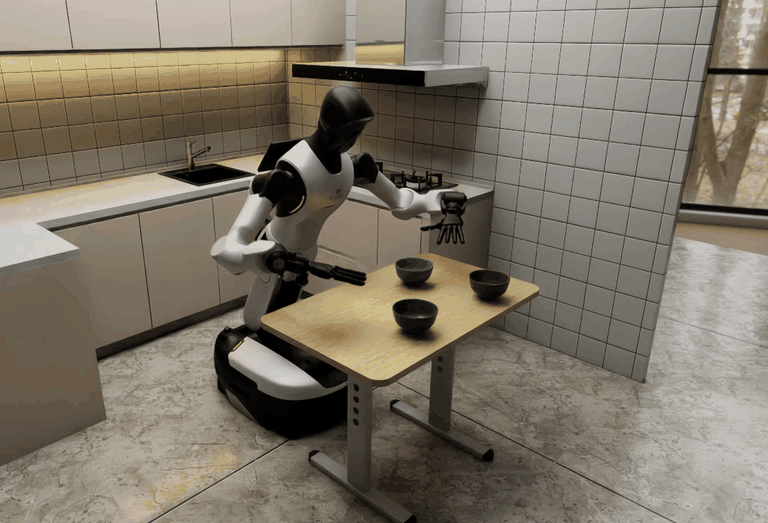
灵巧手叠碗:Astra能够接近、接触,但是尝试抓取失败
灵巧手取书:Astra多次调整抓取姿态,仍取书失败
精细操作:积木入孔成功,手机充电屡屡失败。
圆形积木入孔时,Astra 调整接近方向,完成了抓取与插入。
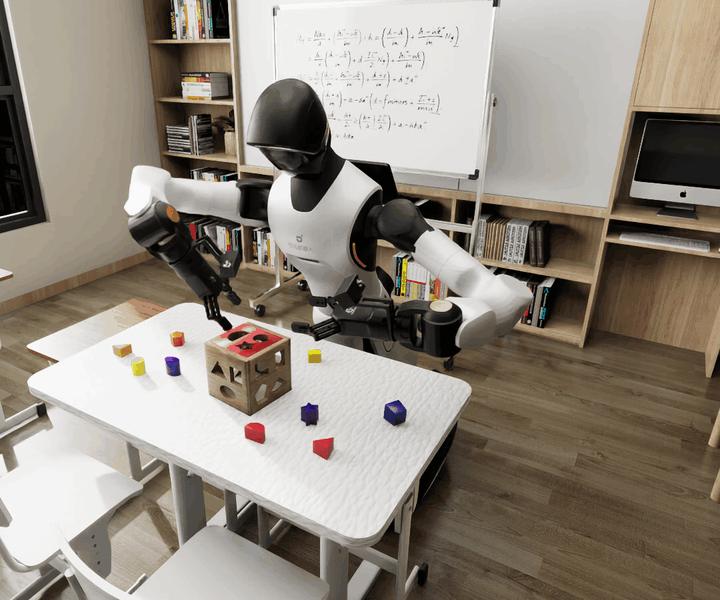
积木入孔:Astra夹取圆形积木并完成入孔
换成手机充电,情况就不同了:即使增加了针对细小物体的抓取指导、通过了两段拾取检查,最终仍未完成插接。找到接口、选对方向、在接触过程中保持对齐,依然困难。
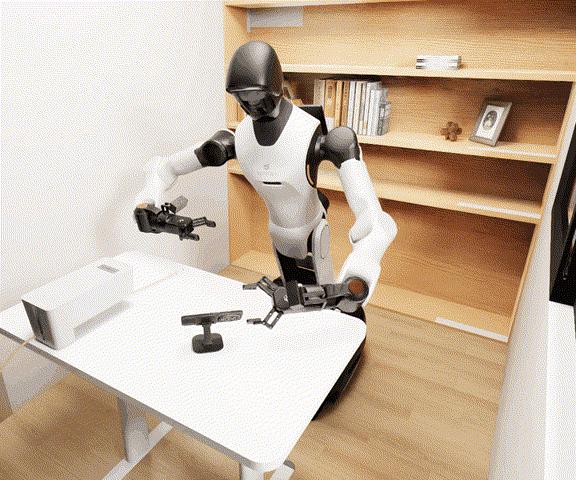
手机充电:Astra抓取成功,但充电口方向错误无法接入
真机验证:能叠积木、能把毛巾对折,完整叠衣服无法完成。
在 ARX Lift2 真机上,Astra 完成了物体选择、抓取、放置与积木堆叠。接入深度信息后还完成了毛巾折叠,但更长的多阶段叠衣服任务仍未成功。
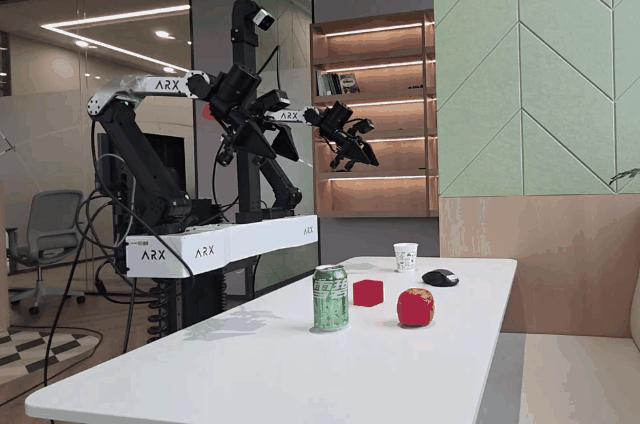
指定物体抓取:Astra成功完成
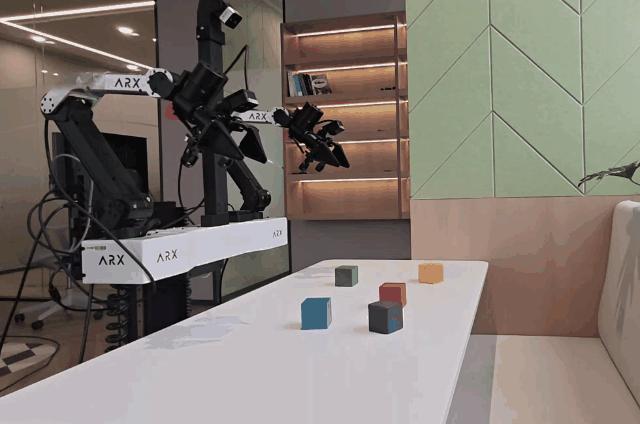
按颜色抓取积木:Astra成功完成
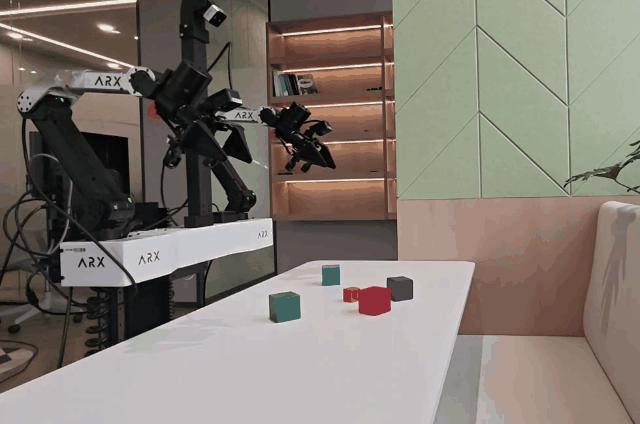
按大小抓取积木:Astra成功完成
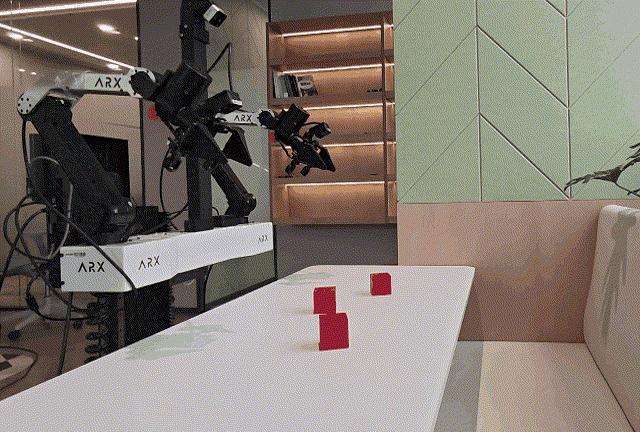
积木堆叠:Astra成功完成
叠毛巾:增加深度信息,Astra成功完成
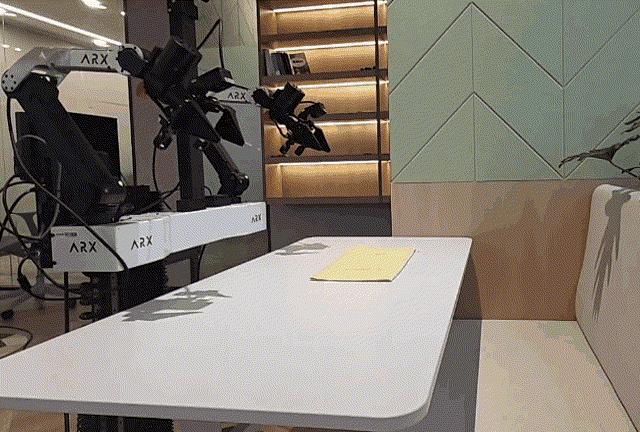
叠衣服:增加深度信息,Astra仍无法完成
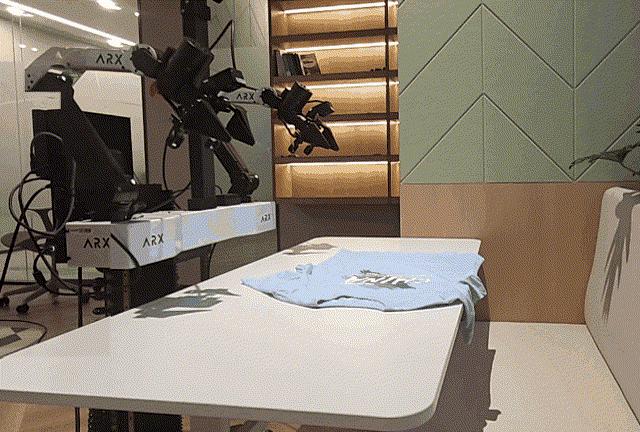
这组实验呈现出清晰的能力边界:Astra 已在全身协同和跨本体操作中表现突出,但灵巧手控制和精密插接,仍是需要突破的关口。
对于擅长这些能力的策略模型,挑战旗舰大模型的机会,就藏在这些具体任务里。
06三巨头旗舰齐聚具身角斗场,等你的模型来挑战
GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argon已经踏入RoboColiseum具身角斗场。本轮评测揭示的短板——精细操作和灵巧手控制——都是后来者可以战胜它们的地方。
我们邀请研发VLA、WAM和Agent系统的研发团队,带着自己的模型进入RoboColiseum具身角斗场,与三巨头旗舰正面交锋。
三巨头的旗舰模型展示了实力,也暴露了短板。下一个击败它们的,可能就是你的模型。
RoboColiseum: https://robocoliseum.ai/
Techreport: https://robocoliseum.ai/techreport
进入 RoboColiseum 具身角斗场
参与评测,发起挑战!


