

近日,在由艾伦人工智能研究所(AI2)发起的全球权威具身智能零样本评测基准 MolmoSpaces 最新榜单上,魔法原子旗下面向通用机器人操作的 VLM Agent 框架 EchoPolicy-0 以 75.4%的机器人操作平均成功率位列 MolmoSpaces Combined 榜单全球第一,覆盖抓取、抓取放置、打开与关闭全部 4 个 v1 任务。
同一榜单、同一分组下,魔法原子自研具身智能 Agent 框架 MagicBrain 凭借 3.4B 参数规模,以 72.4%的机器人操作平均成功率位列 MolmoSpaces Combined 榜单全球第四,其抓取成功率达到 94.4%,远超行业平均水平。
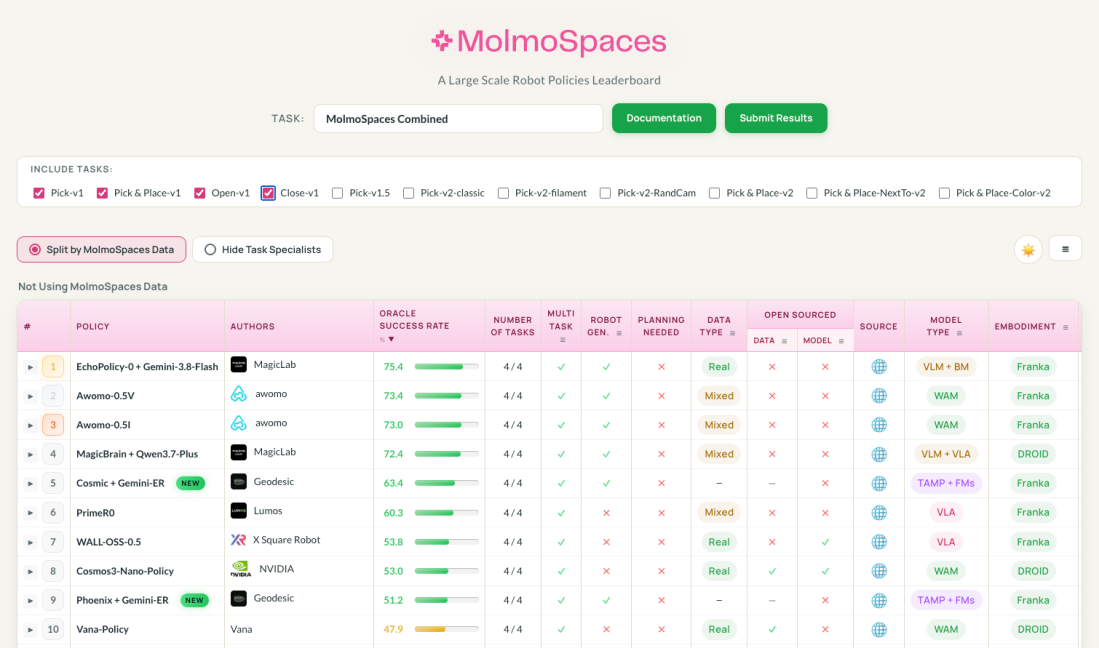
魔法原子旗下具身智能 Agent 框架 EchoPolicy-0 位列 MolmoSpaces 榜单第一
MolmoSpaces 榜单是目前全球具身智能领域最具公信力的零样本评测基准,面向操作、导航与更长程的具身任务。基准明确给出初始场景、机器人与相机配置、任务指令和成功条件,完整清单、统一计分与公开结果能够把零散演示转化为可比较的数据。机器人需要面对超出固定演示环境的情况,在不同背景、几何结构与物体分布下寻找目标,并根据局部条件完成任务。
魔法原子 EchoPolicy-0 与 MagicBrain 框架参与的四项 v1 任务涉及自由物体抓取、关节物体交互和多阶段操作,从不同侧面考察具身智能 Agent 框架的系统能力,而不是只看一个单项指标。
魔法原子研发实验室 MagicLab Studio 负责人表示:“在具身大脑的路线上,我们认可分层架构这种方式,并发现指令遵循能力是当前模型在通用任务上遇到的一个难点。EchoPolicy 通过 Agent 框架及轨迹打分的方式来保证指令遵循能力;MagicBrain 通过端到端视觉引导的方式来优化指令遵循效果,两者均取得了较好的结果。”
EchoPolicy-0 :让机器人多任务共享一套思考与行动方式
机器人要完成一项任务,需要把语言目标、视觉观察与物理动作持续连接起来。这些动作看起来各不相同,但背后是同一组跨任务问题:目标在哪里,当前状态是什么,应该调用哪种能力,动作是否达到目的,失败之后如何继续。
魔法原子 MagicLab Studio 围绕这些问题,将视觉语言模型、几何操作工具与通用动作策略组织为统一的 VLM Agent 框架 EchoPolicy-0 ,让观察环境、理解目标、选择能力、执行动作,以及观测验证结果形成闭环。不同任务共享这套机制,具体的接触和运动由相应执行器完成。
EchoPolicy-0 框架研发负责人表示:“ EchoPolicy-0 的通用性体现在让能力能够被统一调用、组合和验证。 EchoPolicy-0 当前版本已在 Franka 单臂平台上完成四类操作验证,为继续扩展任务提供共同基础。”
在 VLA 的使用方式上,魔法原子 MagicLab Studio 引入了 VLM 目标引导的多候选轨迹选择:让动作模型先提出多种可能的候选运动轨迹,将候选投影到图像平面,再依据 VLM 指定的目标选择更匹配的轨迹,并在执行后持续验证。高层视觉理解由此参与低层动作选择,而不仅停留在任务分解。
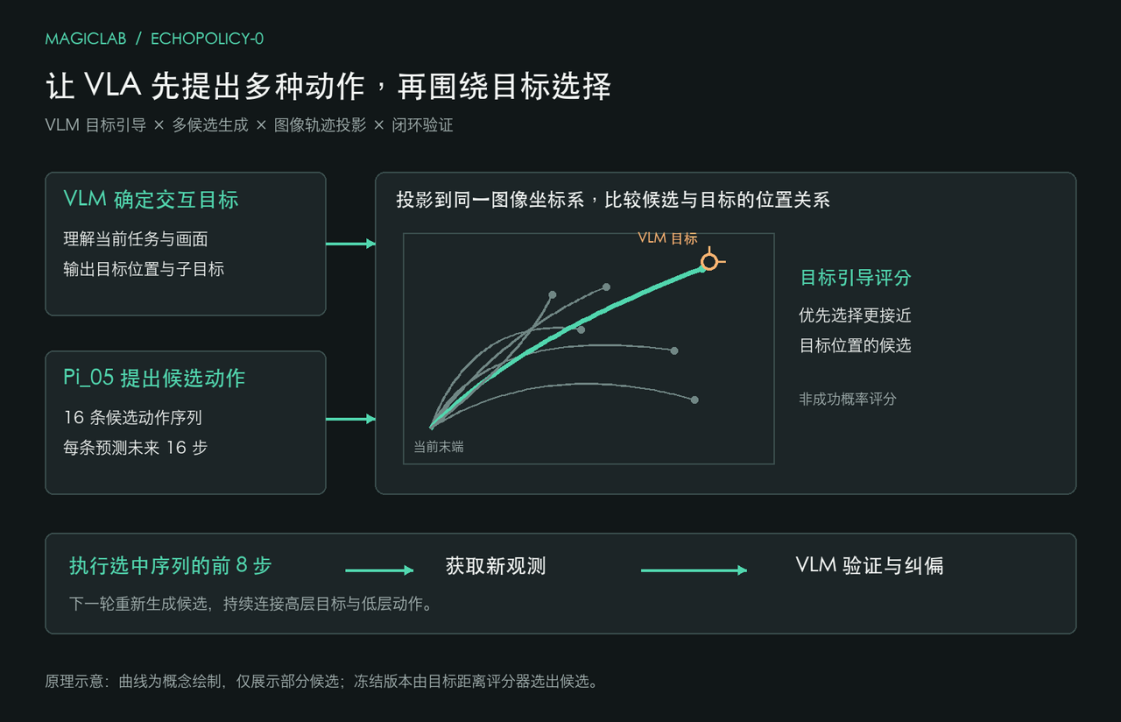
EchoPolicy-0 VLM 框架多候选轨迹选择原理
EchoPolicy-0 框架在 MolmoSpaces 的四项操作任务上完成了 3915 局全量评测,取得了 75.4% 的四项任务等权平均成功率,截至 2026 年 10 月 13 日,位列 MolmoSpaces Combined 全球第一。
魔法原子将 EchoPolicy-0 框架在 MolmoSpaces 上的四项评测视为一次系统验证,同时用逐局结果指导后续迭代。EchoPolicy-0 展示了一条面向通用机器人操作的系统路线,统一 Agent 框架能够组织不同类型的操作能力:由 VLM Agent 组织语义目标和任务状态,由几何工具提供可检查的空间交互,由通用动作策略生成候选,通过 VLM 目标引导的轨迹选择约束动作方向,再由持续验证把它们连接起来。
EchoPolicy-0 针对具身智能模型落地场景,回答了一个问题:模型提出来的动作,怎么保证选的是对的那一个?EchoPolicy-0 不改模型的输入,而是在模型给出的多套候选动作里,按视觉目标筛出更匹配的一条,并在执行后持续验证。对下游客户而言,这条路线的价值不在单点成功率上——新增一类任务时,不必再从零搭一套系统,只要把能力接进同一套框架即可。
自研大脑:MagicBrain 让模型能“看见” 从“演示可用”逼近“产线可用”
魔法原子的具身智能 Agent 框架 MagicBrain ,同样在 MolmoSpaces 四项操作任务上完成了 3915 局全量评测,四项 v1 任务平均成功率 72.4%,位列全球第四。其中,抓取(Pick-v1)、抓取放置(Pick & Place-v1)两项任务拿下了所在榜单的全球第一,抓取任务成功率高达 94.4%。
VLA 是当前具身智能领域备受关注的模型架构,其语言跟随能力是行业内由来已久的共性问题。让模型执行“把苹果放进篮子”这类指令,包含了两件对它并不容易的事:先理解“苹果”这个名词,再在像素层面找出哪个是“苹果”。
魔法原子在研发测试中发现,抓取失败的案例里,绝大多数不是动作执行不稳,而是抓错了对象,或者放错了位置。换句话说,VLA 在动作学习上已经足够强,问题出在把名词短语绑定到图像区域环节——想抓“苹果”却抓成旁边的“梨”,错不在手,而在眼睛。
实际上,VLA 对视觉信号的跟随能力,强于对语言指令的跟随。为此,MagicBrain 采用了一套被称为 In-Context Visual Guidance(上下文视觉引导)的技术路线,VLA 只负责做动作,找目标这件事,交给更擅长看图的 VLM Agent。
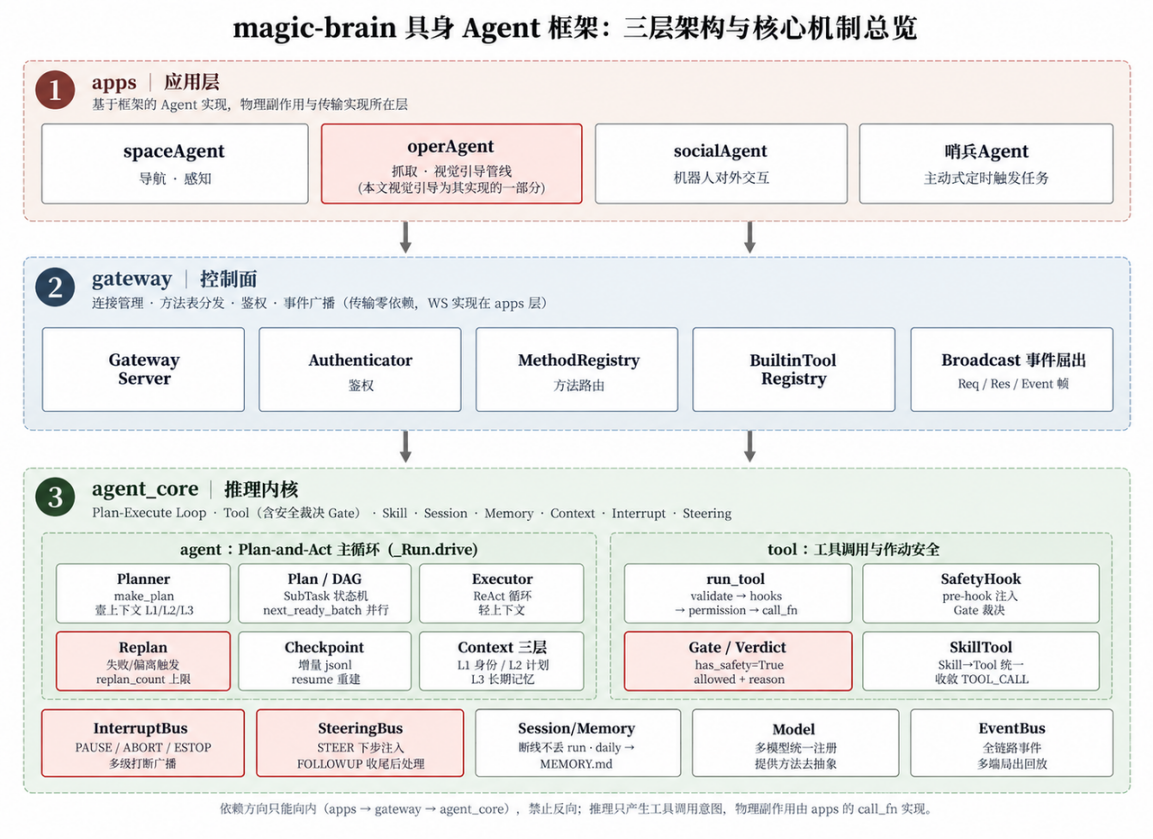
具身智能Agent框架 MagicBrain 三层架构层级图
MagicBrain 提供了一个更省力的分工范式。语言说清“做什么”,像素说清“是哪个、在哪里”,把两路信息各交给擅长的模型,它没有引入新的模型结构,没有堆砌更大的参数量,只是重新排布了信息的传递路径。
“我们在 VLA 理解语言的基础上,让它进一步去‘看见’,并且知道该看什么”,魔法原子 MagicLab Studio 负责人表示,这一技术路线不依赖提升参数规模来换取大模型性能,此次参与评测的模型参数规模仅为 3.4B。
行业层面,魔法原子回答了一个备受关注的问题:VLA 到底能不能用得起、用得上。抓取与放置是具身智能从实验室走向真实场景的高频基础动作——工厂分拣、仓储搬运、家庭整理都依赖它。抓取成功率从此前 70% 到 94.4% 的跨越,意味着 VLA 正从“演示可用”逼近“产线可用”的临界线,扩大了具身智能可商业化的场景边界。
魔法原子的 “具身大脑” 设计哲学
“在 MolmoSpaces 榜单上拿到了全球第一,但魔法原子关心的,是榜单背后那个真正的问题:具身智能机器人的大脑,到底应该怎么长,长在哪里。”魔法原子 MagicLab Studio 负责人表示。
魔法原子认为,具身智能应沿着分层协同的技术路线推进:由上层模型负责理解、规划与纠错,由底层模型负责将任务意图转化为可靠的物理动作。
目前,分层架构在行业内已被广泛讨论,其中一个关键问题仍未得到充分解决:上层的任务意图,如何被底层准确理解并稳定执行。
魔法原子 MagicLab Studio 尝试了两种互补的解决思路。
第一种是本次拿下 MolmoSpaces 榜单第一的 EchoPolicy-0,通过 Agent 调度、候选选择和闭环验证,提高执行与指令的一致性。这一技术路线的优势在于可以在不重新训练底层模型的情况下,通过改进调度、选择和验证机制快速迭代,提升已有模型的任务完成能力。
MagicBrain 的思路是:在上下层之间加一层显式视觉引导,配合配套训练,提高动作生成阶段的目标对齐能力。该方法无需改变 VLA 的网络架构,通过配套后训练,使模型学会将视觉标记与操作语义、动作行为联系起来,从而降低仅依赖语言指令时的歧义。
两种思路分别作用于“动作生成”与“执行、选择、验证”两个环节,具有较强的互补性:视觉引导帮助底层生成更符合目标的动作,Agent 调度则负责选择、执行、检查和纠错。
此次 EchoPolicy-0 拿下第一、MagicBrain 拿下第四,两条路径的有效性都得到了验证。
谈及未来,魔法原子表示:“下一阶段,我们将进一步探索二者的结合,形成从任务理解到物理执行的完整反馈闭环;进入真实工业场景,持续检验任务成功率、运行稳定性和部署成本,完善数据与模型平台;把经过验证的能力沉淀为可复用的技能模块、标准接口和解决方案,同时系统积累成功、失败及人工纠正数据,建立'部署—采集—训练—评测—再部署'的持续迭代机制,推动工程经验转化为基础模型能力。”


